Як я зі штучним інтелектом молекули малював
В 2025-му році я мав честь читати
біоорганічну хімію в КШЕ,
а цього року фізичну хімію в КАІ.
В обох курсах мені ну дуже вже хотілося продемонструвати, як виглядають молекули та їх орбіталі.
Це могло би суттєво допомогти студентам зрозуміти механізми хімічних реакцій,
так як в більшості випадків вони передбачають перекриття правильних орбіталей та "перетікання" електронів,
яке хіміки-органіки зображають спеціальними діаграмами
(push-arrow diagrams).
На жаль, я не є спеціалістом у квантовій хімії, але в мене був штучний інтелект і нестримне бажання зробити круті лекції.
З цього я і почав.
Увесь код в проекті написано виключно штучним інтелектом, я тільки підбадьорював його теплими словами як справдешній прораб.
Результати цього неподобства представлено в
репозитарії на GitHub.
В статті будуть 3D-ілюстрації, з яких я прибрав більшу частину орбіталей, щоб їх не засмічувати,
тож якщо хто хоче "оголосити весь список" — ласкаво прошу в галерею на GitHub.
Нижче мій особистий досвід: з якими проблемами зіткнувся, які рішення ухвалив та які висновки зробив.
То як же намалювати красиво?
Крок 1. Вводимо дані
Для того, щоб почати хоч щось рахувати, треба якось сказати комп'ютеру,
що саме я зібрався рахувати, тож виникло питання:
як задати хімічну формулу у зрозумілому машині форматі?
Теоретично назви за IUPAC, наприклад "β-D-arabino-Hex-2-ulofuranosyl α-D-gluco-hexopyranoside",
могли б вирішити це питання, але на практиці це як мінімум незручно.
Також є більш програмістський варіант — SMILES, але людині з ними важко працювати
(якщо назву за IUPAC я ще з горем пополам запишу, то цю штуку тільки з довідника брати).
Тому в ідеалі хотілось інструмент, який дозволяв би зобразити формулу — так я буду впевнений, що рахуватися буде саме потрібна мені речовина.
З доступних інструментів мою увагу привернули три: Ketcher, MarvinJS та JSME:
- MarvinJS: розібравшись детальніше, я відкинув його, бо незважаючи на зручність, він є ліцензійним та закритим.
- JSME: добре проявляє себе, коли треба зобразити багато молекул на одній сторінці, але він доволі застарілий.
- Ketcher: врешті-решт я зупинився саме на ньому.
Ketcher дозволяє малювати структури вручну, а також підтримує кілька форматів, в яких можна завантажити дані, зокрема SMILES.
Також він дозволяє експортувати в ряд форматів, тож намалювавши молекулу, я можу, наприклад, зберегти собі SMILES у текстовий файл і в майбутньому перевикористати.
Приклад інтерфейсу Ketcher.
Можна поклацати, але жодного бекенду не передбачено, тож нічого цікавого після вводу молекули не відбудеться.
Зате можна отримати уявлення, як виглядає інтерфейс дуже багатьох інструментів для хіміків
(вони як дві краплі води, якщо чесно).
На жаль, дане рішення неідеальне і деякі молекули я так і не зміг ввести в Ketcher, але для лекційних демонстрацій він покриває 99% моїх потреб тільки так.
[18]аннулен —
Та єдина найвпертіша молекула, яка була мені потрібна для лекцій і яку я так і не зміг намалювати в Ketcher.
SMILES теж не допомогли.
Тут представлена тільки конфігурація атомів у просторі, трохи пізніше подивимось на деякі орбіталі.
Крок 2. Тривимірні координати та орбіталі
Щоб одночасно отримати тривимірні координати атомів та електронні орбіталі, необхідно уже проводити квантово-механічні розрахунки.
Я не стану вдаватись в деталі, скажу тільки, що така задача надзвичайно обчислювально складна.
Складна до такого рівня, що отримати точний розв'язок рівняння Шредінгера для багатоелектронної молекули практично неможливо за розумний час.
Тому в реальних розрахунках використовують наближені методи,
як-от теорія функціонала густини (DFT), які забезпечують різний компроміс між швидкістю та точністю.
Щоб впоратися з таким у межах мого маленького проекту, очевидно, треба обрати якийсь добрий уже готовий інструмент.
Я розглянув кілька варіантів:
- ORCA: дуже хороший потужний пакет, може, навіть занадто потужний :)
Ліцензія дозволяє некомерційне використання для навчання (те, що треба).
З мінусів: може бути складно з установкою, бінарні залежності, доведеться парсити просто гігантські вихідні файли.
- Gaussian: ліцензійний пакет, використовується у багатьох комерційних та навчальних проектах.
Шикарна штука, але, як співала група "Пирятин": нема грошей.
- RDKit / OpenBabel (MMFF94, UFF): класичні силові поля.
Розрахунки буквально миттєві (мілісекунди), але сам підхід більше схожий на класичну механіку пружинок,
тож ніяких орбіталей, а результат може відрізнятися від реального.
Такий підхід був би хорошим, якщо потрібно отримати на льоту правдоподібну форму молекули,
але для своєї задачі я його відкинув.
- GFN2-xTB (Grimme): напівемпіричний квантовий метод.
На моєму ноубуці десь у $1000$ разів швидший за DFT,
ідеальний для первинної 3D-оптимізації геометрії та швидкого пошуку мінімумів.
У підсумку я зупинився на ньому як методі першого вибору.
Для більшості молекул він видає результат, який мене повністю влаштовує,
а ті випадки, де я бачу явну помилку, я віддаю на розтерзання наступному методу.
- PySCF (Python-based Simulations of Chemistry Framework): реалізує методи Kohn-Sham DFT (B3LYP, PBE, тощо),
паралелізується через OpenMP/BLAS, дає прямий доступ до матриць густини, коефіцієнтів MO та базисних наборів у NumPy.
Суперпотужна машинерія.
Окрім того, ще й з відкритим кодом та написаний на знайомих мені з колишньої роботи Python та C/C++.
Це вже важка артилерія на випадок, якщо швидкий метод не впорався і я бачу, що молекулу якось неправильно покрутило.
У підсумку користувацький інтерфейс отримав випадаюче меню з пунктами:
- GFN2-xTB — швидка оптимізація для більшості випадків;
- PySCF (DFT B3LYP/6-31G*) — важка артилерія для особливо "впертих" молекул.
Крок 3. Я хочу бачити результат
Всі ці розрахунки — то, звичайно, чудово, але хочеться нарешті побачити красиву картинку.
Знову ж таки, я надав перевагу використанню існуючих інструментів замість писати з нуля навіть при підтримці всезнаючого штучного інтелекту.
Цього разу в список на розгляд потрапило наступне:
- Three.js: відома бібліотека тривимірної графіки, дає абсолютний контроль,
але не має специфічного для задачі функціоналу, тож довелося б самостійно реалізовувати відображення молекул та ізоповерхонь орбіталей.
Навіть зі штучним інтелектом це виглядало надто складно.
- NGL Viewer: потужний переглядач, особливо якщо йдеться про структуру білків.
Останній дозволяє переглядати їх у стилі Ribbon/Cartoon, але для простих молекул це занадто,
тож я вирішив зупинити свій вибір на чомусь більш простому.
- 3Dmol.js: легкий, спеціалізований WebGL-рушій.
Нативно підтримує побудову ізоповерхонь орбіталей як на основі cube-файлів, так і сіток трикутників,
забарвлення поверхонь (наприклад, для ESP), а також підписи атомів та анімацію молекулярних структур.
От його я і вирішив використати.
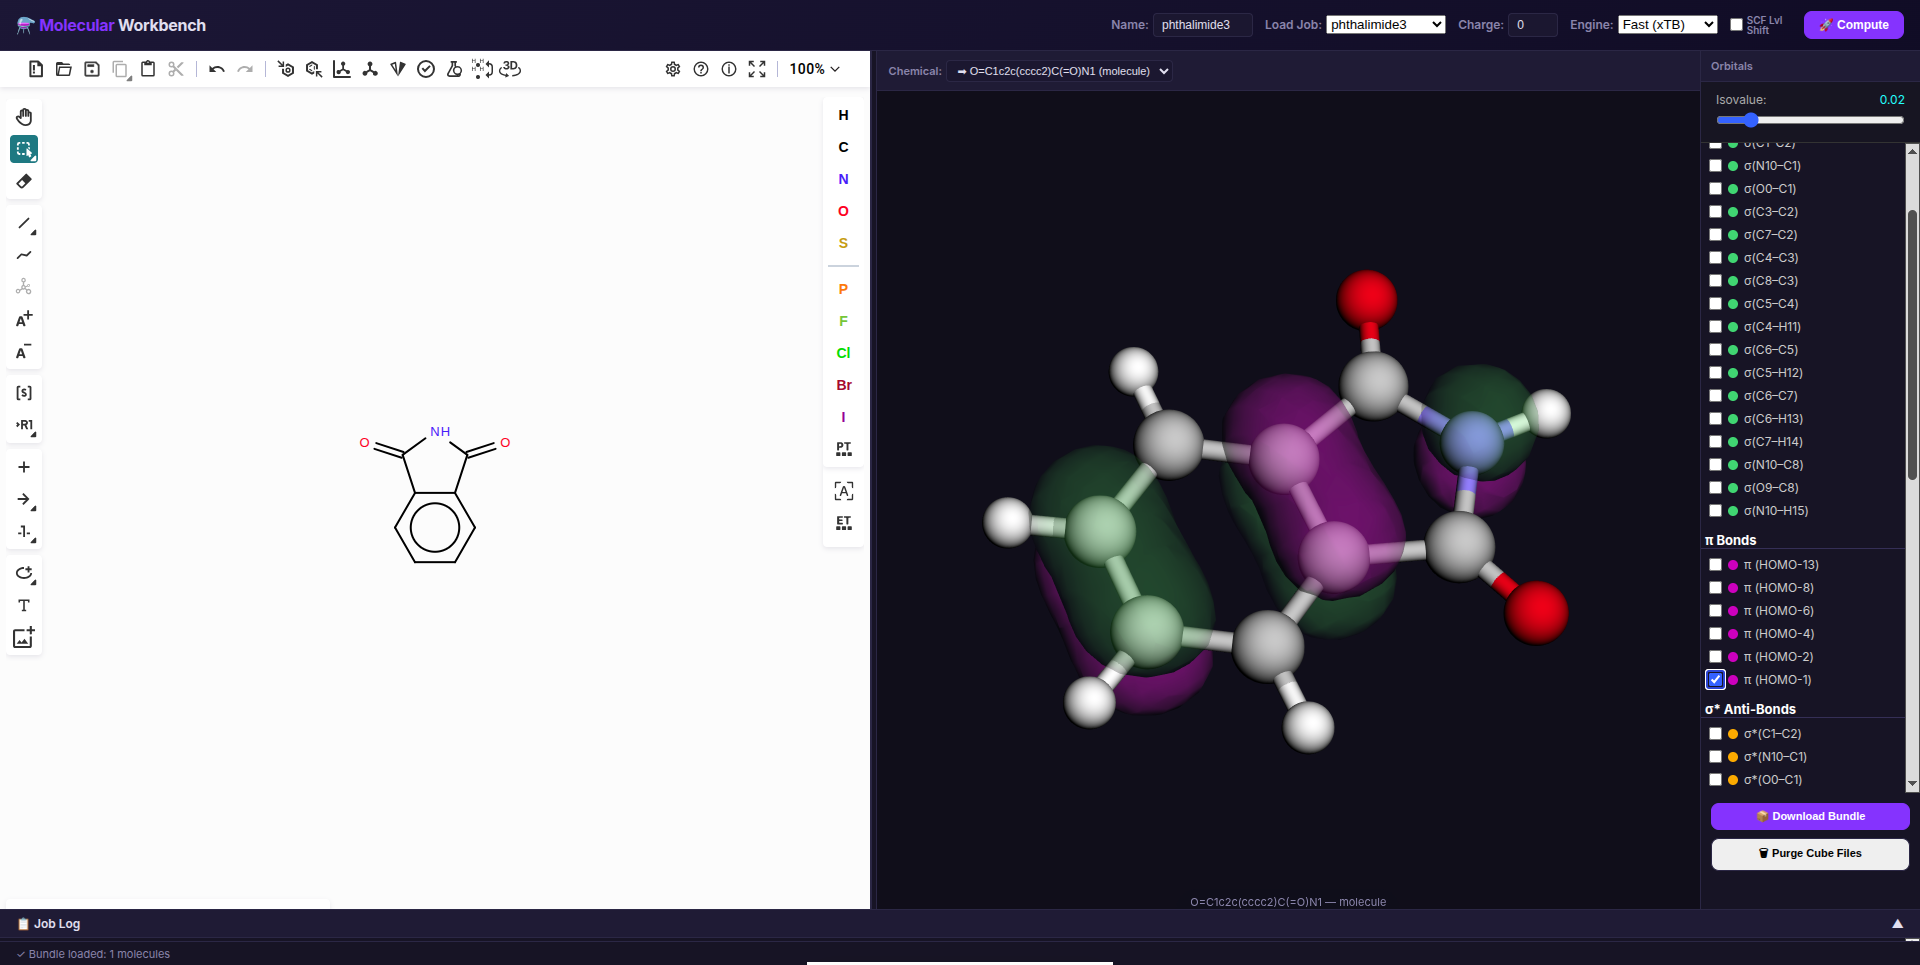
Робочий стіл системи.
Так виглядає те, що бачу я, коли готую черговий пакет для лекцій.
Частина інтерфейсу повинна бути вже знайомою,
тоді як решта стане зрозуміла по ходу розповіді.
А в чому проблема-то була?
Не сумніваюсь, що поки що вся задача виглядає для читача як "поєднати кілька інструментів" та ще й за допомогою штучного інтелекту.
Очевидно, що таке повинно робитися за вечір і точно вже не заслуговує цілої статті.
Ну хіба що дуже хочеться пографоманити.
Насправді, я був би просто щасливий, якби воно так було, але сувора реальність як завжди вносить свої корективи.
А що ж повертають квантові обчислення?
Відповідь інженера — cube-файли зі значеннями хвильової функції; відповідь фізика/хіміка — канонічні орбіталі.
Ну а хіба це не те, що ми й хотіли? На жаль, ні.
Справа в тому, що хоча ми і не кажемо цього явно, але ж очікуємо на картинку, яку бачили у підручнику органічної хімії, чи принаймні щось достатньо схоже.
Етан, етен та етин —
класичний приклад одинарного, подвійного та потрійного зв'язку.
Орбіталі показано тільки для зв'язку вуглець-вуглець, щоб не засмічувати графік.
Легко бачити, що одинарний зв'язок — $\sigma$,
тоді як подвійний складається з одного $\sigma$- та одного $\pi$-зв'язку,
а потрійний — з одного $\sigma$- та двох $\pi$-зв'язків.
Повертаючись до проблеми: ми би хотіли чогось подібного... і ми його швидше за все не отримаємо.
Розв'язок рівнянь Кона-Шема дає власні функції оператора Кона-Шема (канонічні молекулярні орбіталі, CMO),
а вони можуть бути делокалізовані по всій молекулі.
Якщо подивитися на яку-небудь $\text{CMO}_{16}$, то це розмазня на 20 атомів — жоден студент-хімік не впізнає там звичний $\sigma$-зв'язок $\ce{C-C}$.
Так і що нам робити?
Нам необхідна так звана локалізація.
Як я казав вище, "розмазня" — це власний базис оператора Кона-Шема (канонічні молекулярні орбіталі),
а як відомо, базиси можна змінювати, наприклад за допомогою унітарного перетворення (узагальненого повороту).
Таким чином, виникає питання: чи можемо ми так вибрати новий набір базових функцій серед зайнятих орбіталей,
щоб їх комбінації давали ту саму загальну електронну густину,
і при цьому наші нові орбіталі були якнайбільш схожі на звичні нам картинки з підручника?
Як виявилось, такі методи є. Я розглянув наступні:
- Foster-Boys: класичний метод мінімізації просторової дисперсії орбіталей.
На жаль, він не розрізняє $\sigma$- і $\pi$-симетрію,
тож за певних умов може згорнути $\ce{C=O}$ або $\ce{C=C}$ у два еквівалентні вигнуті "бананові зв'язки" (banana bonds).
Математично хвильова функція та сама, але хімікам я таке показувати не буду.
- Pipek-Mezey (1989): максимізує заселеність за Маллікеном,
тому в плоских системах зазвичай краще зберігає розділення $\sigma$- та $\pi$-зв'язків.
Проте він сильно залежить від базису та може давати дещо неочікувану картину на гетероатомах,
тож я його теж відкинув — обійдусь без сюрпризів.
- IBO (Intrinsic Bond Orbitals, Knizia, 2013): використовує концепцію Intrinsic Atomic Orbitals (IAO) як проміжний проектор.
IBO зазвичай добре відтворює звичну нам із підручника структуру Льюїса,
вдало розділяючи $\sigma$-каркас і $\pi$-систему.
На ньому я й зупинився в якості основного інструмента.
Як промаркувати орбіталі
Ймовірно, ви очікували, що локалізація дасть нам красиву картинку і класифікацію всього, що ми нарахували, ото тільки бери і малюй.
Як би не так — нам світить тільки трохи менша "розмазня", а класифікувати доведеться взагалі самим.
В рамках класифікації було б добре показати вільні електронні пари, $\sigma$- та $\pi$-зв'язки.
Для цього я використав наступний алгоритм:
- Крок 1: Аналіз заселеності атомів у локалізованих орбіталях (Gross Mulliken population для IBO):
- Якщо $\ge 88\%$ заселеності зосереджено на одному атомі (не $\ce{H}$),
орбіталь класифікується як неподілена електронна пара (Lone Pair).
- Якщо заселеність розподілена між кількома атомами,
але становить $\ge 78\%$ на головному атомі та $< 14\%$ на будь-якому іншому
(зазвичай відтік зумовлений негативною гіперкон'югацією), це все ще неподілена електронна пара.
Як і в попередньому пункті, діє виключення для водню.
- Якщо внесок понад $10\%$ мають рівно два атоми і орбіталь не є LP,
вона класифікується як 2-центровий зв'язок ($\pi$ чи $\sigma$).
Поріг у $10\%$ було буквально вистраждано:
при $5\%$ поляризовані вільні пари кисню в карбонільній групі $\ce{C=O}$ "чіпляють" хвіст на вуглеці і помилково маркуються як зв'язки,
а при $15\%$ поляризовані $\pi$-зв'язки хибно стають 3-центровими.
- Якщо суттєва заселеність ($>10\%$) розподілена між трьома і більше атомами,
орбіталь позначається як багатоцентровий зв'язок (мітка
delocalized).
Така ситуація часто виникає в ароматичних системах, спряжених $\pi$-системах або за сильної гіперкон'югації.
- Всі інші випадки класифікатор відкидає.
- Крок 2: Розрізнення $\sigma$- та $\pi$-симетрії для зв'язків з кроку 1 через контурне дискретне сканування:
- Водень та атоми вуглецю з $\ge 4$ зв'язаними сусідами апріорі не утворюють $\pi$-зв'язків
і одразу маркуються як $\sigma$-зв'язок.
- Для решти знаходимо середину зв'язку між двома атомами з найбільшим внеском у цю орбіталь.
У цій точці будуємо два кола радіусами $0.45$ та $0.85\text{ Bohr}$ ($\sim 0.24$ та $\sim 0.45~$Å) у площині,
перпендикулярній до між'ядерної осі зв'язку.
По кожному колу дискретно розраховуємо значення хвильової функції $\psi_i = \psi(\vec{r}_i)$ у $12$ точках ($i = 1,\dots,12$).
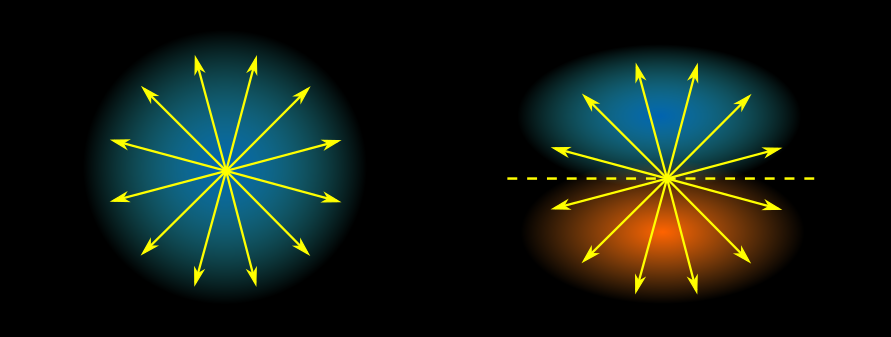
- Точки, де амплітуда є близькою до нуля ($|\psi_k|/\max_i|\psi_i| \le 0.10$), відкидаються.
Якщо залишиться менше $4$-х точок, то орбіталь буде за замовчуванням класифіковано як $\sigma$-зв'язок.
Та сама доля очікує на орбіталі з $\max_i|\psi_i| < 10^{-5}$.
- Серед решти значущих точок рахується кількість додатних $N_+$ та від'ємних $N_-$,
а також $N_{inv}$ — кількість інвертованих пар $\psi_i \cdot \psi_{i+6} < 0$.
- Визначається наскільки збалансовані знаки $\beta = 2\min(N_+, N_-)/(N_+ + N_-)$,
де $\beta = 0$ — присутній лише один знак, а $\beta = 1$ — баланс 50/50.
- Орбіталь класифікується як $\pi$-зв'язок, якщо хоча б для одного з кіл виконується одна з умов:
- помірний баланс $\beta > 0.5$ за високої узгодженості вузлової площини ($N_{inv} \ge 3$);
- або виражений баланс $\beta > 0.7$ при $N_{inv} \ge 2$.
- Якщо жодне з кіл не задовільняє ці критерії, то орбіталь вважається $\sigma$-зв'язком.
- Крок 3: милиці, ну куди ж в нашій справі без них?
У сульфатах ($\ce{SO4^{2-}}$) або перхлоратах ($\ce{ClO4-}$) делокалізований характер зв'язування створює додаткові проблеми для нашого класифікатора.
Наївний алгоритм бачив дві $\pi$-взаємодії на один атом кисню і малював... потрійний зв'язок $\ce{S \bond{3} O}$!
- Евристика валентного перехоплення: якщо для одного термінального кисню вже знайдено один $\pi$-зв'язок,
друга $\pi$-подібна делокалізована взаємодія примусово деградує назад у неподілену пару (Lone Pair).
- Метан — найпростіший алкан, з нього часто починають курс органічної хімії.
Містить лише $\sigma$-зв'язки.
- Ацетон — ним пахне той самий клей "Момент" (діти 90-х зрозуміють).
Має $\pi$-зв'язок $\ce{C=O}$.
- Перхлорат— аніон хлорної кислоти.
Зверніть увагу: всі зв'язки $\ce{Cl-O}$ мають помітний $\pi$-характер,
а завдяки симетрії вони еквівалентні,
що приводить до делокалізації заряду між чотирма атомами кисню і стабілізує аніон.
Три інші атоми кисню відтягують електронну густину через $\sigma$-зв'язки, посилюючи індуктивний ефект,
внаслідок чого зв'язок $\ce{O-H}$ сильніше поляризований і протон легше відщеплюється.
Разом ці чинники роблять хлорну кислоту дуже сильною (оціночно $pKa \approx -10$).
Також можна помітити негативну гіперкон'югацію.
А що робити з делокалізованими $\pi$-системами? (Бензол, аліл, карбоксилат $\ce{R-COO-}$)
Тут виникає класичний парадокс локалізації.
Хімік хоче бачити зв'язки $\sigma(\ce{C-C})$ локальними,
але для ароматичного кільця бензолу, алільної системи або резонансного аніону форміату та інших карбоксилатів потрібно показати делокалізовану $\pi$-підсистему.
Це важливо, щоб пояснити резонансні ефекти, які мають суттєвий вплив на стабільність молекули чи іону, а також на її реакційну здатність.
В той же час локалізація IBO намагається розірвати спільну електронну хмару на шматки — почергові подвійний та одинарний зв'язки.
Для того, щоб поєднати такі дві взаємовиключні вимоги, доводиться додавати ще один крок.
- Крок 0: виділення спряжених $\pi$-підсистем, які не будуть передаватися на IBO локалізацію.
- Для кожної трійки зв'язаних атомів $\ce{C}$ та $\ce{N}$ із координаційним числом $\le 3$,
або спряжених гетероатомів ($\ce{O}, \ce{S}$),
запускається BFS-подібний алгоритм.
- Сусідні ненасичені атоми приєднуються до підграфа доки відхилення точок від спільної площини не перевищує $0.50\text{ Bohr}$ ($\sim 0.26~$Å),
а орієнтація локальних нормалей зберігається ($\ge 0.88$).
При виявленні таких орбіталей вони вилучаються з пулу локалізації, тоді як решта передається на IBO.
Для систем із виродженими орбіталями (як бензол, де $\pi_2$ і $\pi_3$ мають однакову енергію і довільну орієнтацію)
ми виконуємо точне вирівнювання вироджених канонічних підпросторів через симетричну Löwdin-ортонормалізацію.
Для кожної орбіталі обчислюється діагональна фоківська енергія $E_k = \langle \phi_k | \hat{F} | \phi_k \rangle$,
а якщо інтеграл перекриття з канонічною граничною МО складає $\ge 90\%$,
орбіталь заміняється на канонічну та позначається міткою (HOMO/LUMO).
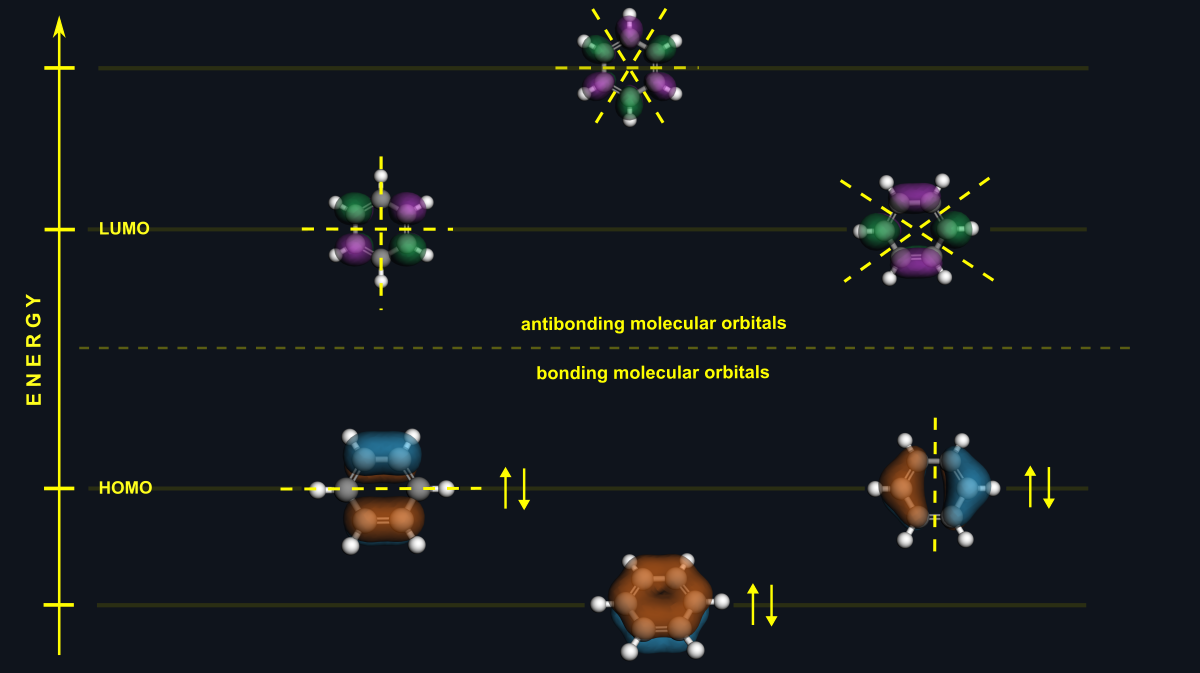
Енергетична схема делокалізованої $\pi$-підсистеми бензолу.
- Бензол.
Перша ароматична молекула, з якою зіштовхуються у курсі хімії.
На цьому демо показано всі орбіталі разом з антизв'язуючими.
Подивіться, наскільки делокалізована $\pi$-підсистема.
- Бута-1,3-дієн.
Тут теж присутне спряження та делокалізація, хоча молекула і не циклічна.
До речі, продовжуючи шаблон подвійний-одинарний зв'язок, можна розмивати орбіталі все більше і більше.
Це зменшує відстань HOMO-LUMO і заганяє такий перехід у видиму область спектра,
тому зустрічається у багатьох природних пігментах,
наприклад, лікопені, що дає червоне забарвлення помідорам.
А ще схожий шаблон у ретиналі, який працює в наших очах, детектуючи світло.
До речі, кому цікаво, як це ми тією самою молекулою бачимо різні кольори, —
дивіться мою лекцію про біохімію зору.
- [18]аннулен — ще одна ароматична молекула як бензол, тільки велика.
- [10]аннулен — класичний приклад, що планарність важлива для ароматичності.
Як і бензол та [18]аннулен має $4n + 2$ електронів в $\pi$-підсистемі,
але не є планарною, тож не ароматична.
Ви можете бачити, що $\pi$-зв'язки всі локалізовані, а не розмиті по кільцю,
ну і саме кільце досить криве.
- Ацетат-іон — спряжена основа оцтової кислоти, класичного прикладу органічної кислоти.
Зверніть увагу на делокалізацію в групі $\ce{-COO^-}$ —
вона розподіляє від'ємний заряд між двома атомами кисню і стабілізує аніон, а отже, сприяє кислотності оцтової кислоти.
Теж дуже добре спостерігається гіперкон'югація.
- Етоксид-іон — спряжена основа етанолу (він же просто спиртяга).
В етоксид-іоні немає аналогічної резонансної стабілізації від'ємного заряду,
тому етанол значно слабша кислота.
Для порівняння, у етанолу $pK_a = 15.9$, а в оцтової кислоти — $pK_a = 4.76$.
Проблема віртуальних антизв'язуючих орбіталей ($\sigma^*$ та $\pi^*$)
У хімії дуже важливо бачити не лише зайняті зв'язуючі орбіталі, а й вільні акцепторні рівні (LUMO, $\sigma^*$, $\pi^*$).
Наприклад, під час нуклеофільної атаки,
зайнята орбіталь нуклеофіла взаємодіє з вакантною акцепторною орбіталлю електрофіла часто з вираженим $\sigma^*$- або $\pi^*$-характером.
Тому було б вкрай непогано якось показати і їх.
Проте у квантовій хімії постає проблема практичної роботи з віртуальним простором.
У наближенні Хартрі-Фока та теорії функціонала густини (DFT) канонічні віртуальні орбіталі є розв'язками для незайнятих одноелектронних станів в усередненому полі електронів.
Оскільки вони не роблять внеску в електронну густину основного стану,
для них не виникає природного критерію локалізації,
аналогічного тому, який ми використовуємо для зайнятих орбіталей.
Іншими словами, на них не діє локалізація IBO, адже там "нікого нема".
В результаті звичні для хіміка валентні антизв'язуючі орбіталі ($\sigma^*$ чи $\pi^*$) не завжди відповідають окремим канонічним віртуальним МО,
а "розмазані" по багатьох віртуальних рівнях і "зібрати назад" їх можна лише як лінійну комбінацію кількох таких МО.
Тому було вирішено піти іншим шляхом — відтворити класичну книжну картинку,
а не просто покладатися на результат оптимізації.
Залежно від того, чи була зв'язуюча орбіталь локалізована IBO, використовується один з двох підходів:
- якщо підсистема пройшла локалізацію (не відібрана на кроці 0),
два найбільші атомні внески зв'язку беруться у протифазі ($c_A - c_B$)
та проектуються у простір вільних орбіталей.
Це дає чіткий локальний антизв'язок, ортогональний до всіх зайнятих орбіталей молекули за побудовою.
- Для делокалізованих спряжених $\pi$-систем (відібраних на кроці 0)
нічого штучно віднімати не потрібно,
бо це виділило б один зв'язок і тим самим порушило делокалізований характер $\pi$-системи (наприклад, у LUMO бензолу),
тож краще чесно виділити їх з віртуального простору цілим блоком.
Для цього віртуальний простір проектується на $p_\perp$-орбіталі атомів фрагмента
(побудовані через IAO, щоб не зачепити дифузні та рідбергівські функції базису),
і через SVD береться стільки напрямків,
скільки атомів у фрагменті мінус кількість зайнятих $\pi$-орбіталей.
Отриманий блок діагоналізується оператором Фока.
Такий комбінований підхід дозволяє зберегти і красиві локальні $\sigma^*$-антизв'язки на кожній зв'язковій ділянці,
і не зруйнувати природну спільну $\pi^*$-систему ароматичних чи резонансних фрагментів.
- Ацетон, знову.
Саме його орбіталь $\pi^*$ атакується нуклеофілом, наприклад $\ce{CN-}$.
Якщо подивитися, як вона розміщена, то стає зрозуміло, звідки береться кут Bürgi-Dunitz (107°).
- Бромометан.
Під час реакції нуклеофільного заміщення $S_N2$ той же самий $\ce{CN-}$ атакує атом вуглецю,
взаємодіючи з $\sigma^*(\ce{C-Br})$-орбіталлю.
- 2-метилпропан-2-ілій, карбокатіон.
Зверніть увагу, як $\sigma$-зв'язки $C-H$, що орієнтовані перпендикулярно до площини молекули,
перекриваються з вакантною $p$-орбіталлю (LUMO) центрального атома.
Ця гіперкон'югація ($\sigma \to p$) ефективно делокалізує позитивний заряд, її наслідком є висока стабільність третинних карбокатіонів.
Останнє сприяє мономолекулярним механізмам реакцій ($S_N1$ та $E1$),
зумовлює регіоселективність за правилом Марковнікова та є рушійною силою 1,2-гідридних і алкільних перегрупувань.
- 2-метилпропан-2-ід, карбаніон.
Протилежна ситуація — надлишковий негативний заряд на центральному атомі.
Так само важливу роль грають зв'язки з воднями, що йдуть перпендикулярно площині,
тільки цього разу вільна електронна пара взаємодіє з розпушуючими $\sigma^*$-орбіталями.
Щоправда, попри певну стабілізацію, він все ще залишається екстремально основним
(спряжена кислота цього карбаніона, ізобутан, має $pK_a \approx 50$).
Заливаємо це щастя на GitHub
Насправді проблема не стільки залити дані (git push впорається),
як проблема: "скільки даних качати браузеру користувача?".
І вона не така маленька, як здається: поширений формат для збереження орбіталей — Gaussian CUBE
(3D-сітка значень хвильової функції, наприклад $100 \times 100 \times 100$ точок).
Один такий файл у нашому випадку займає близько $13\text{ МБ}$,
тобто $32$ орбіталі бензолу обійдуться $\sim 416\text{ МБ}$.
Як рішення проблеми, замість cube-файлів використовуються полігональні сітки,
що відповідають певному значенню амплітуди хвильової функції
(ізоповерхні для додатного та від'ємного значень).
Відповідно, при пакуванні доводиться обирати isovalue
(є відповідний слайдер; зазвичай добре працює $0.045$)
та генерувати сітку алгоритмом Marching Cubes.
Результати зберігаються у форматі JSON та архівуються у ZIP.
Для бензолу повний пакет усіх орбіталей займає лише $1.39\text{ МБ}$
(у розпакованому вигляді JSON-сітки займають $6.82\text{ МБ}$).
З порахованих для лекцій $36$-ти молекул середній розмір ZIP-пакета $1.23\text{ МБ}$,
а найбільший — $6.06\text{ МБ}$,
що чудово вантажиться в браузері за лічені секунди.
Що я з цього виніс
Як не дивно, але навіть дещо цікаве вдалось дізнатись з області фізики.
Наприклад, більшість підручників, поєднуючи модель VSEPR із поясненням через $sp^3$-гібридизацію, стверджують,
що у води $\ce{H2O}$ кисень має гібридизацію $sp^3$, а дві неподілені пари стирчать як "вуха кролика".
Квантові ж розрахунки показали, що канонічні молекулярні орбіталі не еквівалентні!
І що найцікавіше, фотоелектронна спектроскопія дійсно вказує на два різних потенціали іонізації води.
Щоправда, є також роботи, які показують, що унітарним перетворенням можна добитися еквівалентних орбіталей не змінюючи саму багатоелектронну хвильову функцію
(подібно як ми робили при локалізації),
а різницю в спектрі пояснюють релаксацією електронної структури після видалення електрона.
Тож навіть у питанні інтерпретації хімічного зв'язку нема консенсусу:
повинні ми його розуміти як взаємодію молекулярних орбіталей, локалізованих орбіталей,
чи має сенс тільки повний опис багатоелектронною хвилевою функцією?
А для зацікавленого читача можу хіба що порекомендувати кілька статей:
- Laing, M. (1987), "No Rabbit Ears on Water", doi:10.1021/ed064p124
- Grushow, A. (2011), "Is It Time To Retire the Hybrid Atomic Orbital?", doi:10.1021/ed100155c
- Landis & Weinhold (2012), "Comments on 'Is It Time To Retire the Hybrid Atomic Orbital?'", doi:10.1021/ed200491q
- Clauss, A. D. et al. (2014), "Rabbit-ears Hybrids, VSEPR Sterics, and Other Orbital Anachronisms", doi:10.1039/C4RP00057A
- Liu, Y., Frankcombe, T. J. & Schmidt, T. W. (2020), "Visualizing the 30-Dimensional Antisymmetrized Electronic Structure of Water: The Emergence of Lone Pairs", doi:10.1021/acs.jpclett.9b03528
Інший цікавий приклад я зустрів в роботі 2021 року, де використано метод real-space adaptive natural density partitioning,
а кожен зв'язок $\ce{S-O}$ описується однією $\sigma$- та двома еквівалентними $\pi$-взаємодіями.
Але ці $\pi$-внески приблизно на 92% локалізовані на атомах кисню!
Автори прямо зазначають, що вважати їх неподіленими парами кисню, чи справжніми двоцентровими $\ce{S-O}$-зв'язками,
значною мірою залежить від обраного способу інтерпретації.
Кому цікаво, можу лише порекомендувати пару статей:
- Fugel, M. et al. (2019), "Revisiting a Historical Concept by Using Quantum Crystallography: Are Phosphate, Sulfate and Perchlorate Anions Hypervalent?", doi:10.1002/chem.201806247
- Francisco, E. et al. (2021), "Lewis Structures from Open Quantum Systems Natural Orbitals: Real Space Adaptive Natural Density Partitioning", doi:10.1021/acs.jpca.1c01689
Ще один цікавий приклад стосується електронних властивостей алкільних замісників.
У підручниках алкільні замісники часто називають електронодонорними,
маючи на увазі позитивний індуктивний ефект ($+I$).
Але останні роботи ставлять під сумнів саме таке пояснення:
порівняно з атомом водню алкільна група має радше від'ємний індуктивний ефект ($−I$),
а її видима електронодонорність у різних системах пояснюється іншими ефектами.
Наприклад поряд з подвійним зв'язком сусідні $\sigma$-зв'язки $\ce{C-H}$ можуть взаємодіяти з розпушувальною $\pi^*$-орбіталлю
($\sigma(\ce{C-H}) \to \pi^*(\ce{C=C})$), передаючи їй електронну густину — гіперкон'югація.
Вона, зокрема, підвищує енергію HOMO алкену.
- Salvatella, L. (2025), "Rethinking Organic Chemistry: The Dual Electronic Behavior of the Alkyl Group",
doi:10.1021/acs.jchemed.5c00936
- Elliott, M. C. et al. (2025), "Alkyl Groups in Organic Molecules Are NOT Inductively Electron-Releasing",
doi:10.1039/D4OB01572J
- Elliott, M. C., Johnson, E. C. & Gregory, K. P. (2026),
"Rethinking Organic Chemistry: Enhancing Pedagogies to Explain the Relative Reactivity of Aldehydes and Ketones",
doi:10.1021/acs.jchemed.6c00721
З приводу штучного інтелекту
(інструмент: Google Antigravity 2.0, підписка Pro, Opus 5.5 High для архітектури,
Gemini 3.1 Pro High для генерації коду, а після того як гугл його видалив, то Gemini 3.8 Flash High).
Я виявив для себе як ряд переваг, так і цілий список проблем, які доводиться враховувати в роботі.
Спочатку про переваги:
- Моделі дуже універсальні.
Я можу обговорити з нею, що я хочу показати з хімічної точки зору,
тут же, як воно стикується з фізикою, чисельними моделями і чим таке рахувати,
після чого вона мені напише код з використанням бібліотек,
з якими я би рік тільки розбирався, як це... творіння, скажімо, поставити,
а під кінець ще й запропонує, що змоделювати цікавого для біохіміків і дасть готовий SMILES.
Без неї мені б довелось консультуватися з добрим десятком різних спеціалістів,
а потім ще це все кодити,
тож навіть маючи доступ до академічних дідів, проект затягнувся би на роки.
- Сучасні моделі значно менше вигадують неіснуючу літературу,
тож на кожен сумнівний момент можна запросити цитату і звернутися до оригінальної статті.
Проте є ряд (схоже, типових) проблем,
про які не згадати теж буде неправильно.
- Моделі вкрай схильні робити великі файли на тисячі рядків, в яких самі ж плутаються.
- Моделі вкрай схильні по десять разів переімплементовувати одне і те саме навіть у тому ж самому файлі,
тож якщо там буде баг, то іноді простіше викинути весь проект і почати з нуля, ніж шукати всі проблемні місця.
- Періодично рівень вкладеності переростає всі розумні рамки
і в коді починають з'являтися помилки або він не компілюється просто через неправильну табуляцію (особливість Python).
- Якщо написати інструмент, який робить A, а потім інструмент, який робить B,
відладити помилки і попросити злити їх в один інструмент, що робить спочатку A, а потім B, — буде повний провал.
Попри явну вказівку перевикористати готовий функціонал, модель все переімплементує,
акуратно внісши всі помилки, які так довго відладжували, і ще додасть нових.
- Hardcode. Ну це просто жесть.
Сильно спрощуючи: це якби я попросив зробити функцію
add(x,y), яка додає $2$ числа,
а потім виявив, що add(2,2) працює неправильно, і попросив виправити.
Майже гарантовано після цього я отримаю в тілі функції return 4 і для роботи така функція непридатна.
- Створення мертвого коду.
Моделі постійно пишуть функціонал, який не просили,
а на вимогу видалити в кращому разі видалять кнопку його запуску з UI.
Весь код залишиться і модель буде героїчно його підтримувати.
Куди далі?
Мрію зробити повноцінний IRC (intrinsic reaction coordinate) та візуалізацію,
щоб "крутити мультики" як ChemTube3D,
але поки що така задача надто складна і потребує дуже багато правок руками.
Ну, але складно $\neq$ неможливо, то, може, з часом і таке продавлю,
та й моделі стають все розумнішими, може, колись якусь добру ідею підкинуть.
IRC.
Поки що найкращий результат моїх експериментів.
Представляє один з типових механізмів — атаку нуклеофіла на групу $\ce{C=O}$ з утворенням тетраедричного проміжного продукту.
Але навіть тут поки що сумнівні результати розрахунку енергії,
а також я очікував більш суттєвого перенесення електронної густини $\pi$-зв'язку на кисень.
В схемі реакції знизу можна клацати по стрілочках і молекулах,
також працює doubleclick на молекулах.
Подяки
- Штучному інтелекту за те, що написав за мене весь код.
- ТЕЦ-4 за стійкість та електроенергію.
- Андрію (LinkedIn) за ілюстрації до статті.
До речі, крутий дуже спеціаліст (C++/Python, математика/алгоритми).
- Читачам, які аж сюди дочитали... Капєц, ви задроти.